הפיל שבחדר ה- AI: פרטיות, אבטחת מידע ואיך לא שורפים את העסק בריצת אמוק
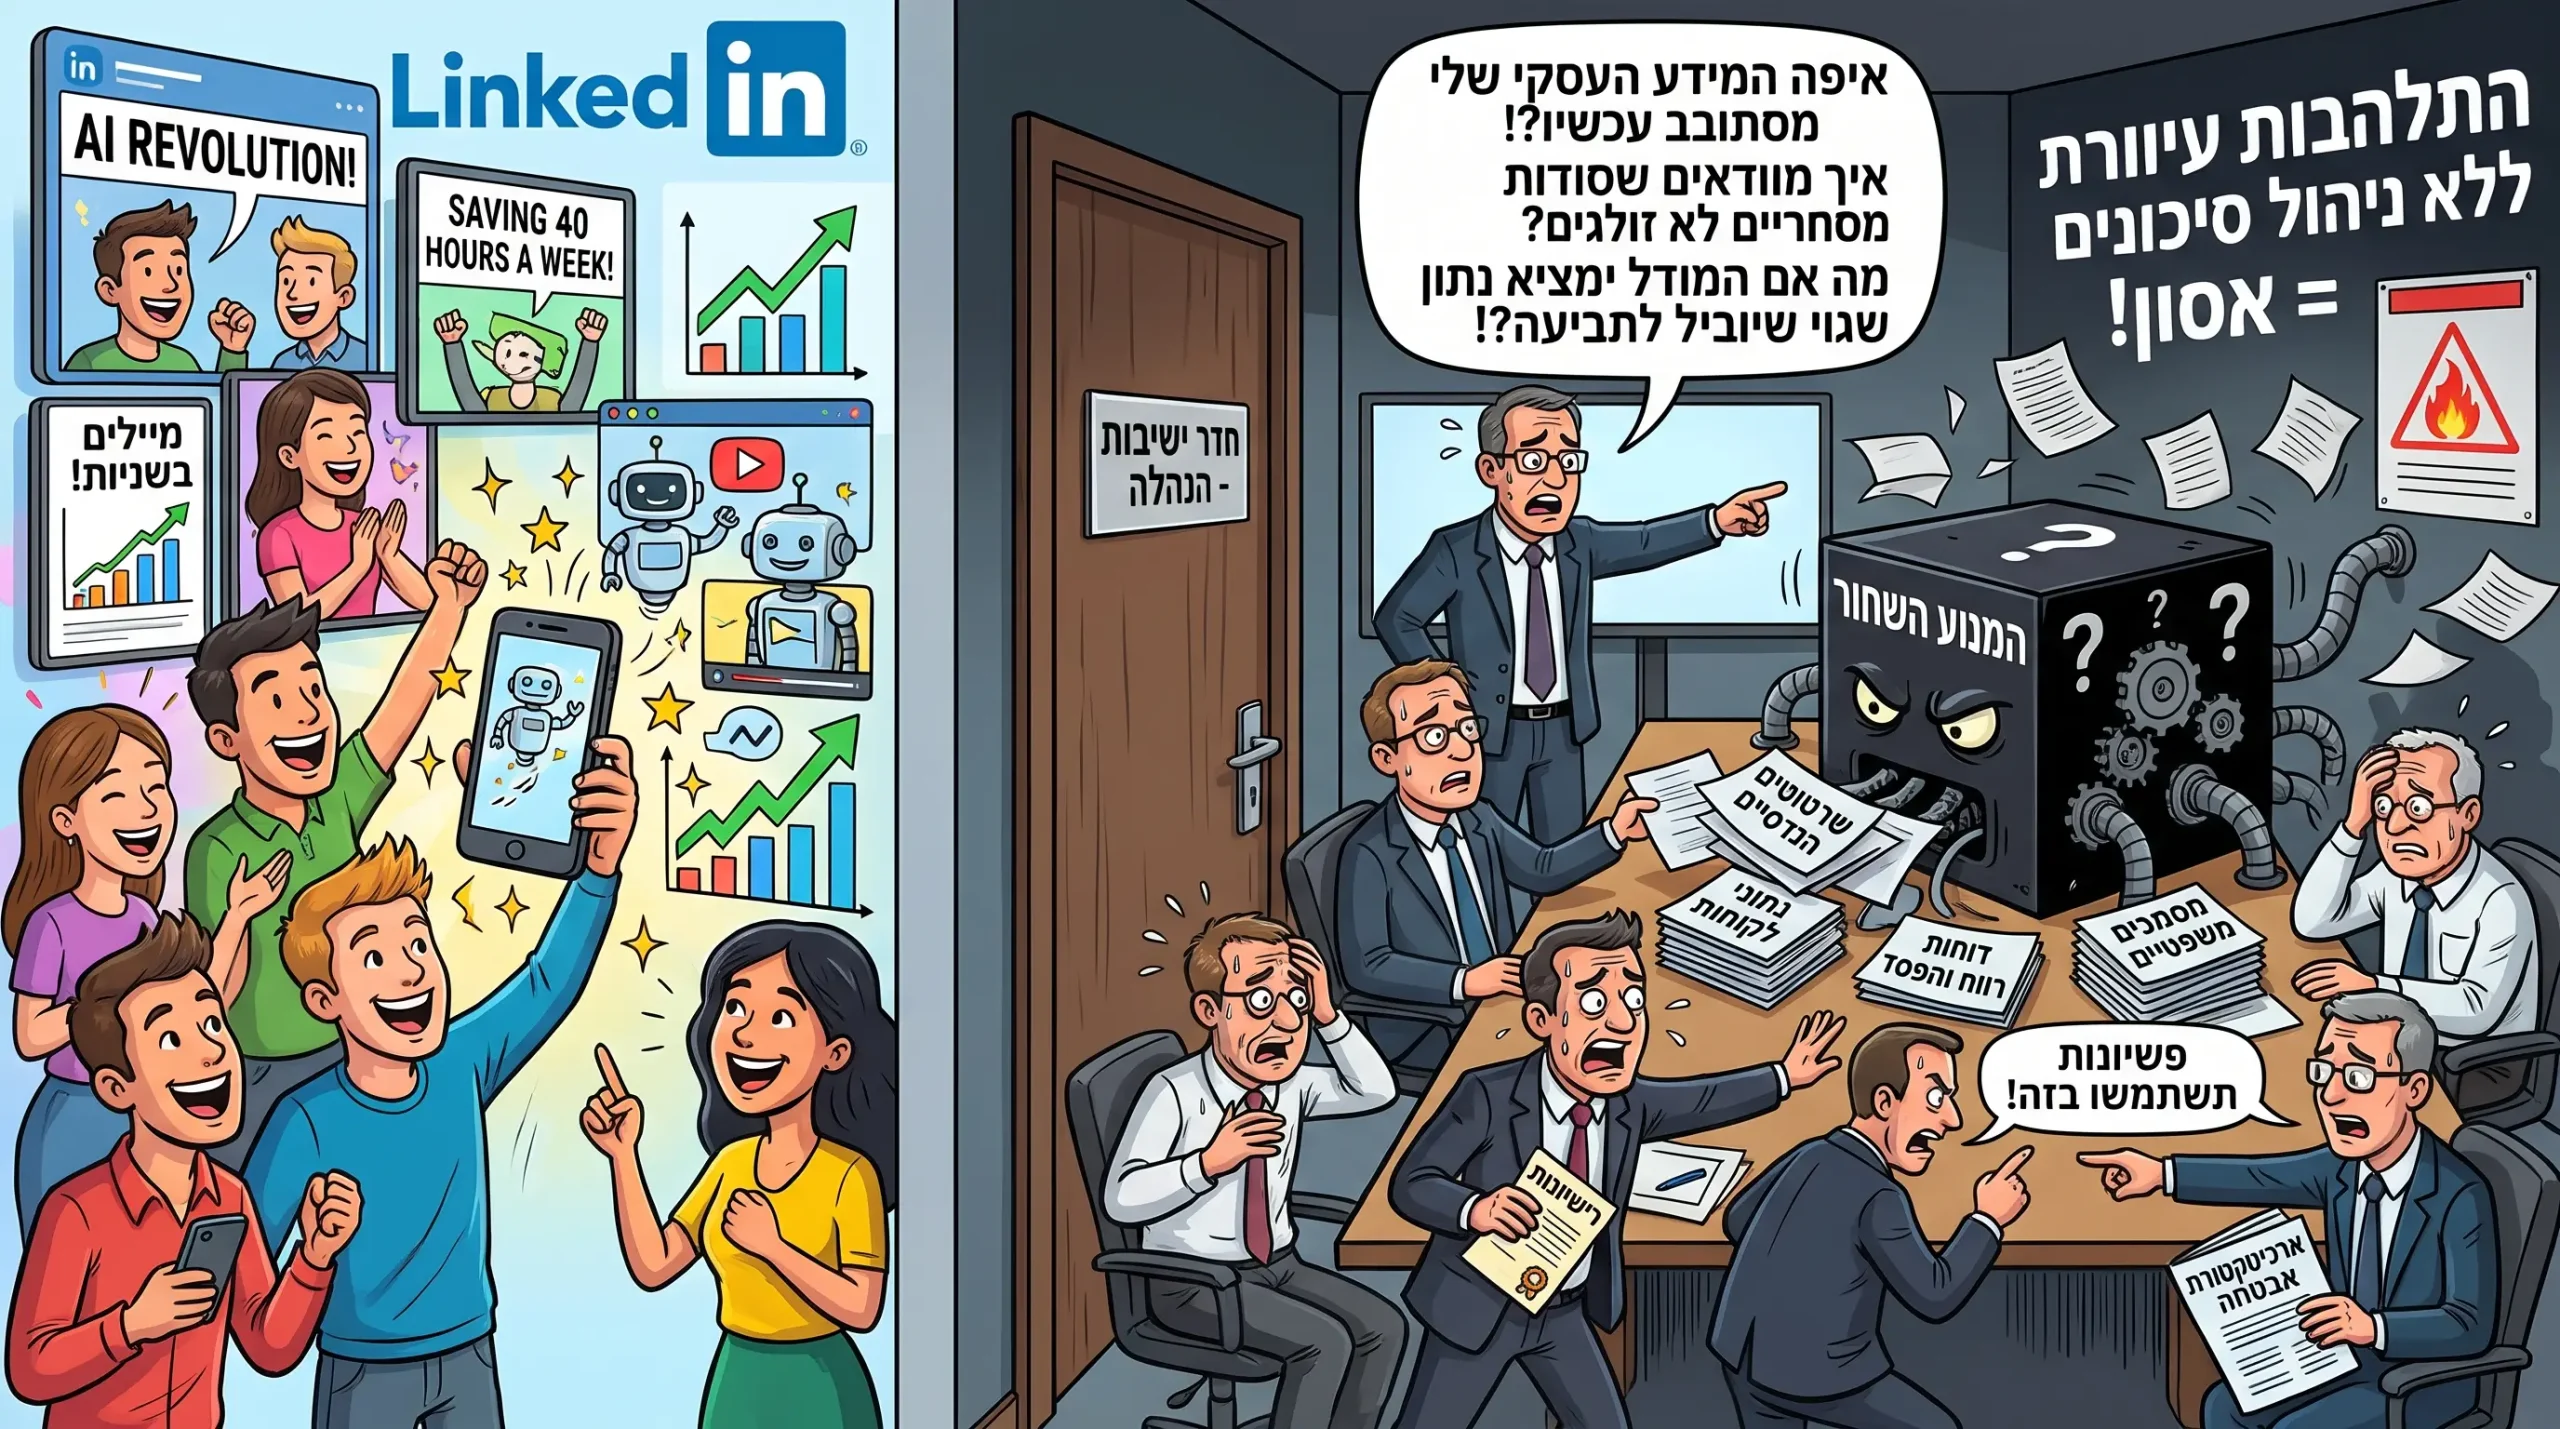
כולם מדברים על כמה בינה מלאכותית מייעלת תהליכים, כותבת מיילים ומייצרת דוחות בשניות.
הפיד בלינקדאין מוצף בהכרזות על "מהפכות יום-יומיות", סרטוני הדגמה מרשימים והבטחות לחיסכון של עשרות שעות עבודה בשבוע.
אבל כשסוגרים את הדלת של חדר הישיבות, מנהלים רבים ומנמ"רים (CIOs) שואלים בדיוק את אותן שאלות מטרידות:
"איפה המידע העסקי שלי מסתובב עכשיו?
איך אנחנו מוודאים שסודות מסחריים לא זולגים החוצה?
ואיך נמנעים ממצב שבו מודל ממציא נתון שגוי שיוביל לתביעה או להפסד כספי כבד?"
החשש הזה אינו עכבה פסיכולוגית או שמרנות מיותרת, הוא מוצדק לחלוטין.
התלהבות עיוורת מטכנולוגיה ללא ניהול סיכונים הנדסי היא מתכון בטוח לתקלות קטסטרופליות.
אי אפשר לקחת נתונים רגישים של לקוחות, שרטוטים הנדסיים, דוחות רווח והפסד, תוכניות תמחור או מסמכים משפטיים, ולזרוק אותם לתוך מנוע שחור שאינכם מבינים כיצד הוא פועל,
היכן הוא שומר את המידע ומי מורשה לגשת אליו.
אם המטרה שלכם היא להטמיע AI בארגון בצורה מקצועית, מבוקרת, מדידה ומעל לכל, בטוחה, לא מספיק "לתת לעובדים רישיונות".
עליכם להבין את שכבות האבטחה, הארכיטקטורה והבקרה הנדרשות. להלן מדריך הנדסי ומעשי לניהול סיכונים נכון בעידן ה- AI.
1. האנטומיה של דליפת מידע: ממשק ווב (Chat) לעומת תשתית API
אחת הטעויות הנפוצות ביותר בקרב הנהלות היא היעדר הבחנה ברורה בין כלי קצה צרכניים לבין תשתיות פיתוח ארגוניות.
ההבדל ביניהם אינו רק עניין של נוחות או מחיר, מדובר בהבדל שבין שמירה קפדנית על סודיות לבין חשיפת המידע הארגוני לסביבה החיצונית.
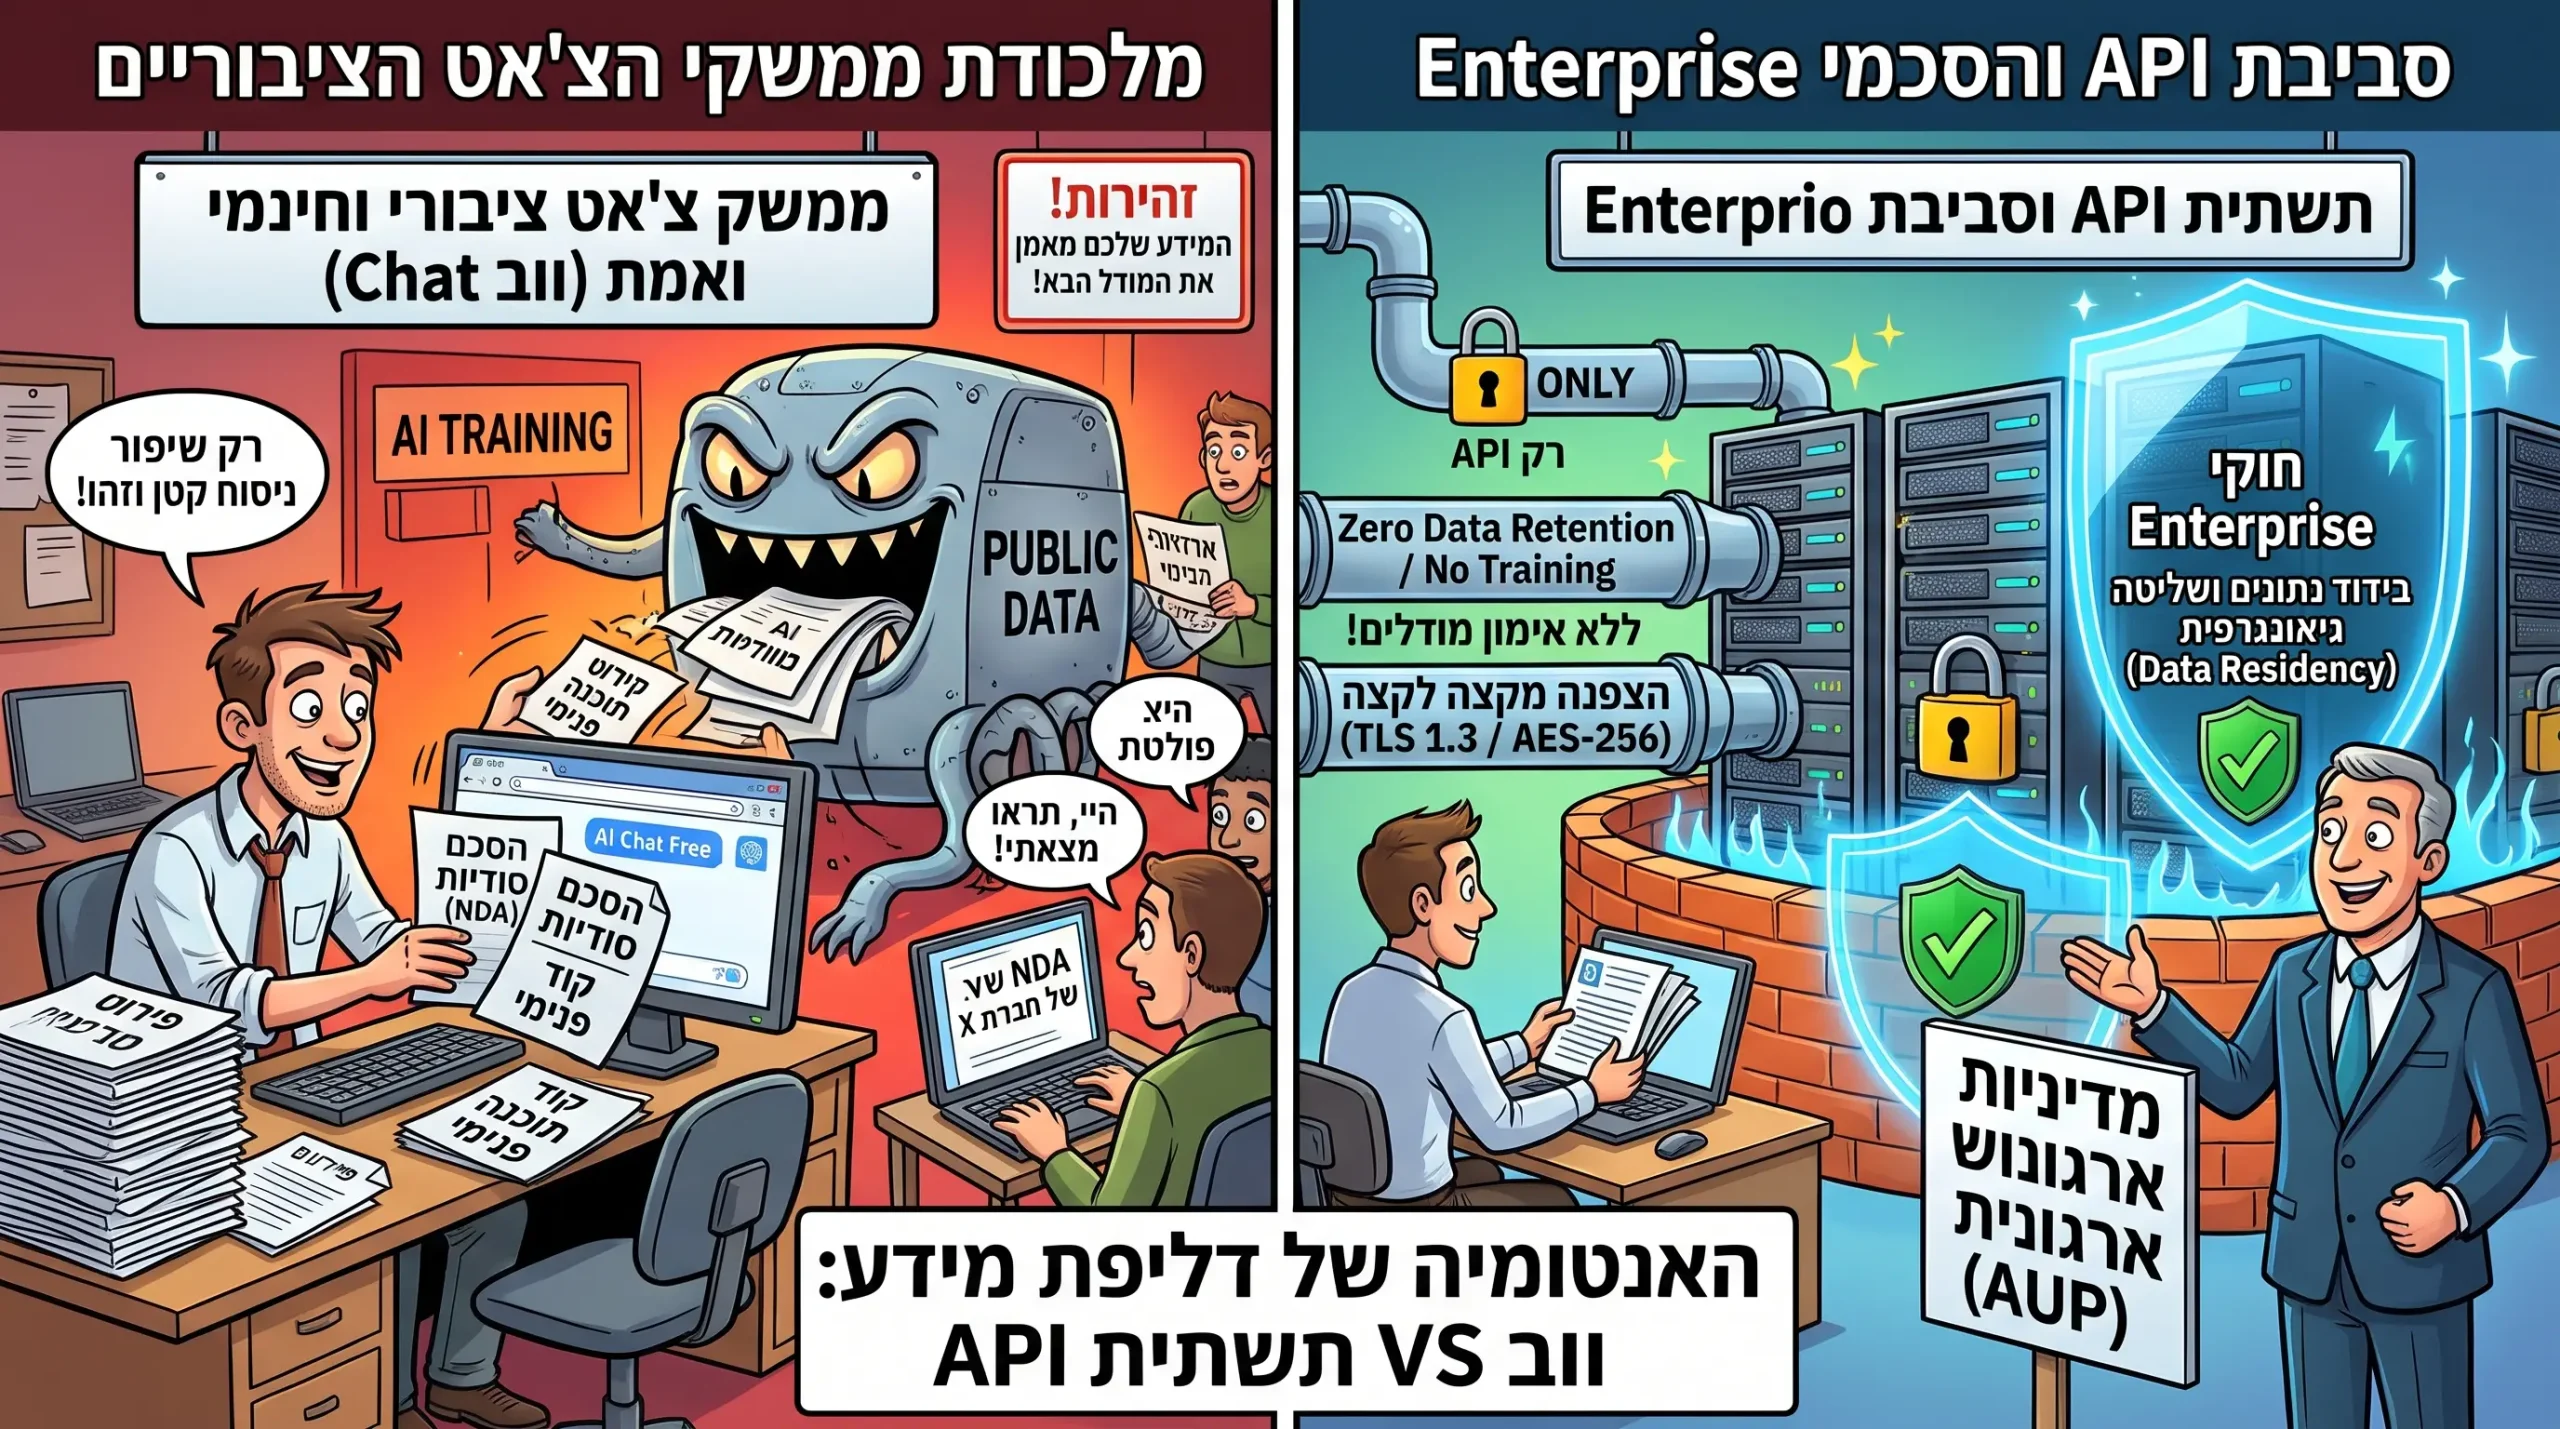
א. מלכודת ממשקי הצ'אט הציבוריים
עובדים רבים פותחים כרטיסייה בדפדפן, מדביקים טיוטת הסכם סודיות (NDA), פירוט שכר או קוד תוכנה פנימי, ומבקשים מהמודל סיכום או שיפור ניסוח.
ברוב הממשקים הצרכניים החינמיים והבסיסיים, הגדרות ברירת המחדל מאפשרות לספקית המודל לשמור את השיחות ולהשתמש בהן לאימון הדורות הבאים של המודלים שלהם.
המשמעות ברורה: המידע הארגוני שלכם הופך לחלק ממשקולות המודל הבא, ויכול, בתנאים מסוימים של שאילתות מתאימות, לצוף אצל משתמשים אחרים.
ב. סביבת API והסכמי Enterprise
לעומת ממשקי הווב, עבודה מבוססת API (ממשק תכנות יישומים) וסביבות Enterprise (כמו OpenAI API, Anthropic Claude API, Google Cloud Vertex AI,
או Microsoft Azure OpenAI) פועלת תחת חוקים שונים בתכלית:
– Zero Data Retention / No Training: הספקיות הגדולות מתחייבות חוזית וטכנולוגית שנתונים הנשלחים דרך ה-API אינם משמשים לאימון מודלים ציבוריים.
– הצפנה מקצה לקצה: המידע מוצפן הן בעת מעבר (In Transit – TLS 1.3) והן בעת מנוחה (At Rest – AES-256).
– בידוד נתונים ושליטה גיאוגרפית (Data Residency): ארגונים יכולים לבחור באילו אזורים גיאוגרפיים (למשל באיחוד האירופי או בארה"ב) המידע יעובד ויישמר,
בהתאם לדרישות הרגולציה המקומית.
– השורה התחתונה למנהלים: יש לגבש מדיניות שימוש ארגונית ברורה (Acceptable Use Policy).
מנעו מעובדים להזין מידע רגיש לגרסאות צרכניות חינמיות, ונתבו את כל התהליכים הקריטיים לתשתיות מאובטחות ברמת Enterprise.
2. הזיות (Hallucinations): איך כופים על המודל לדייק עובדתית
מודלי שפה גדולים (LLMs) הם מנועי חיזוי סטטיסטיים מתקדמים; הם אינם מאגרי מידע מוחלטים ואינם מבינים "אמת" כפי שבני אדם תופסים אותה.
המודל מחשב בכל רגע נתון מהי המילה הסבירה ביותר שתופיע בהמשך המשפט. כאשר שואלים מודל שאלה מורכבת בתחום ספציפי בלי לספק לו את המקורות המתאימים,
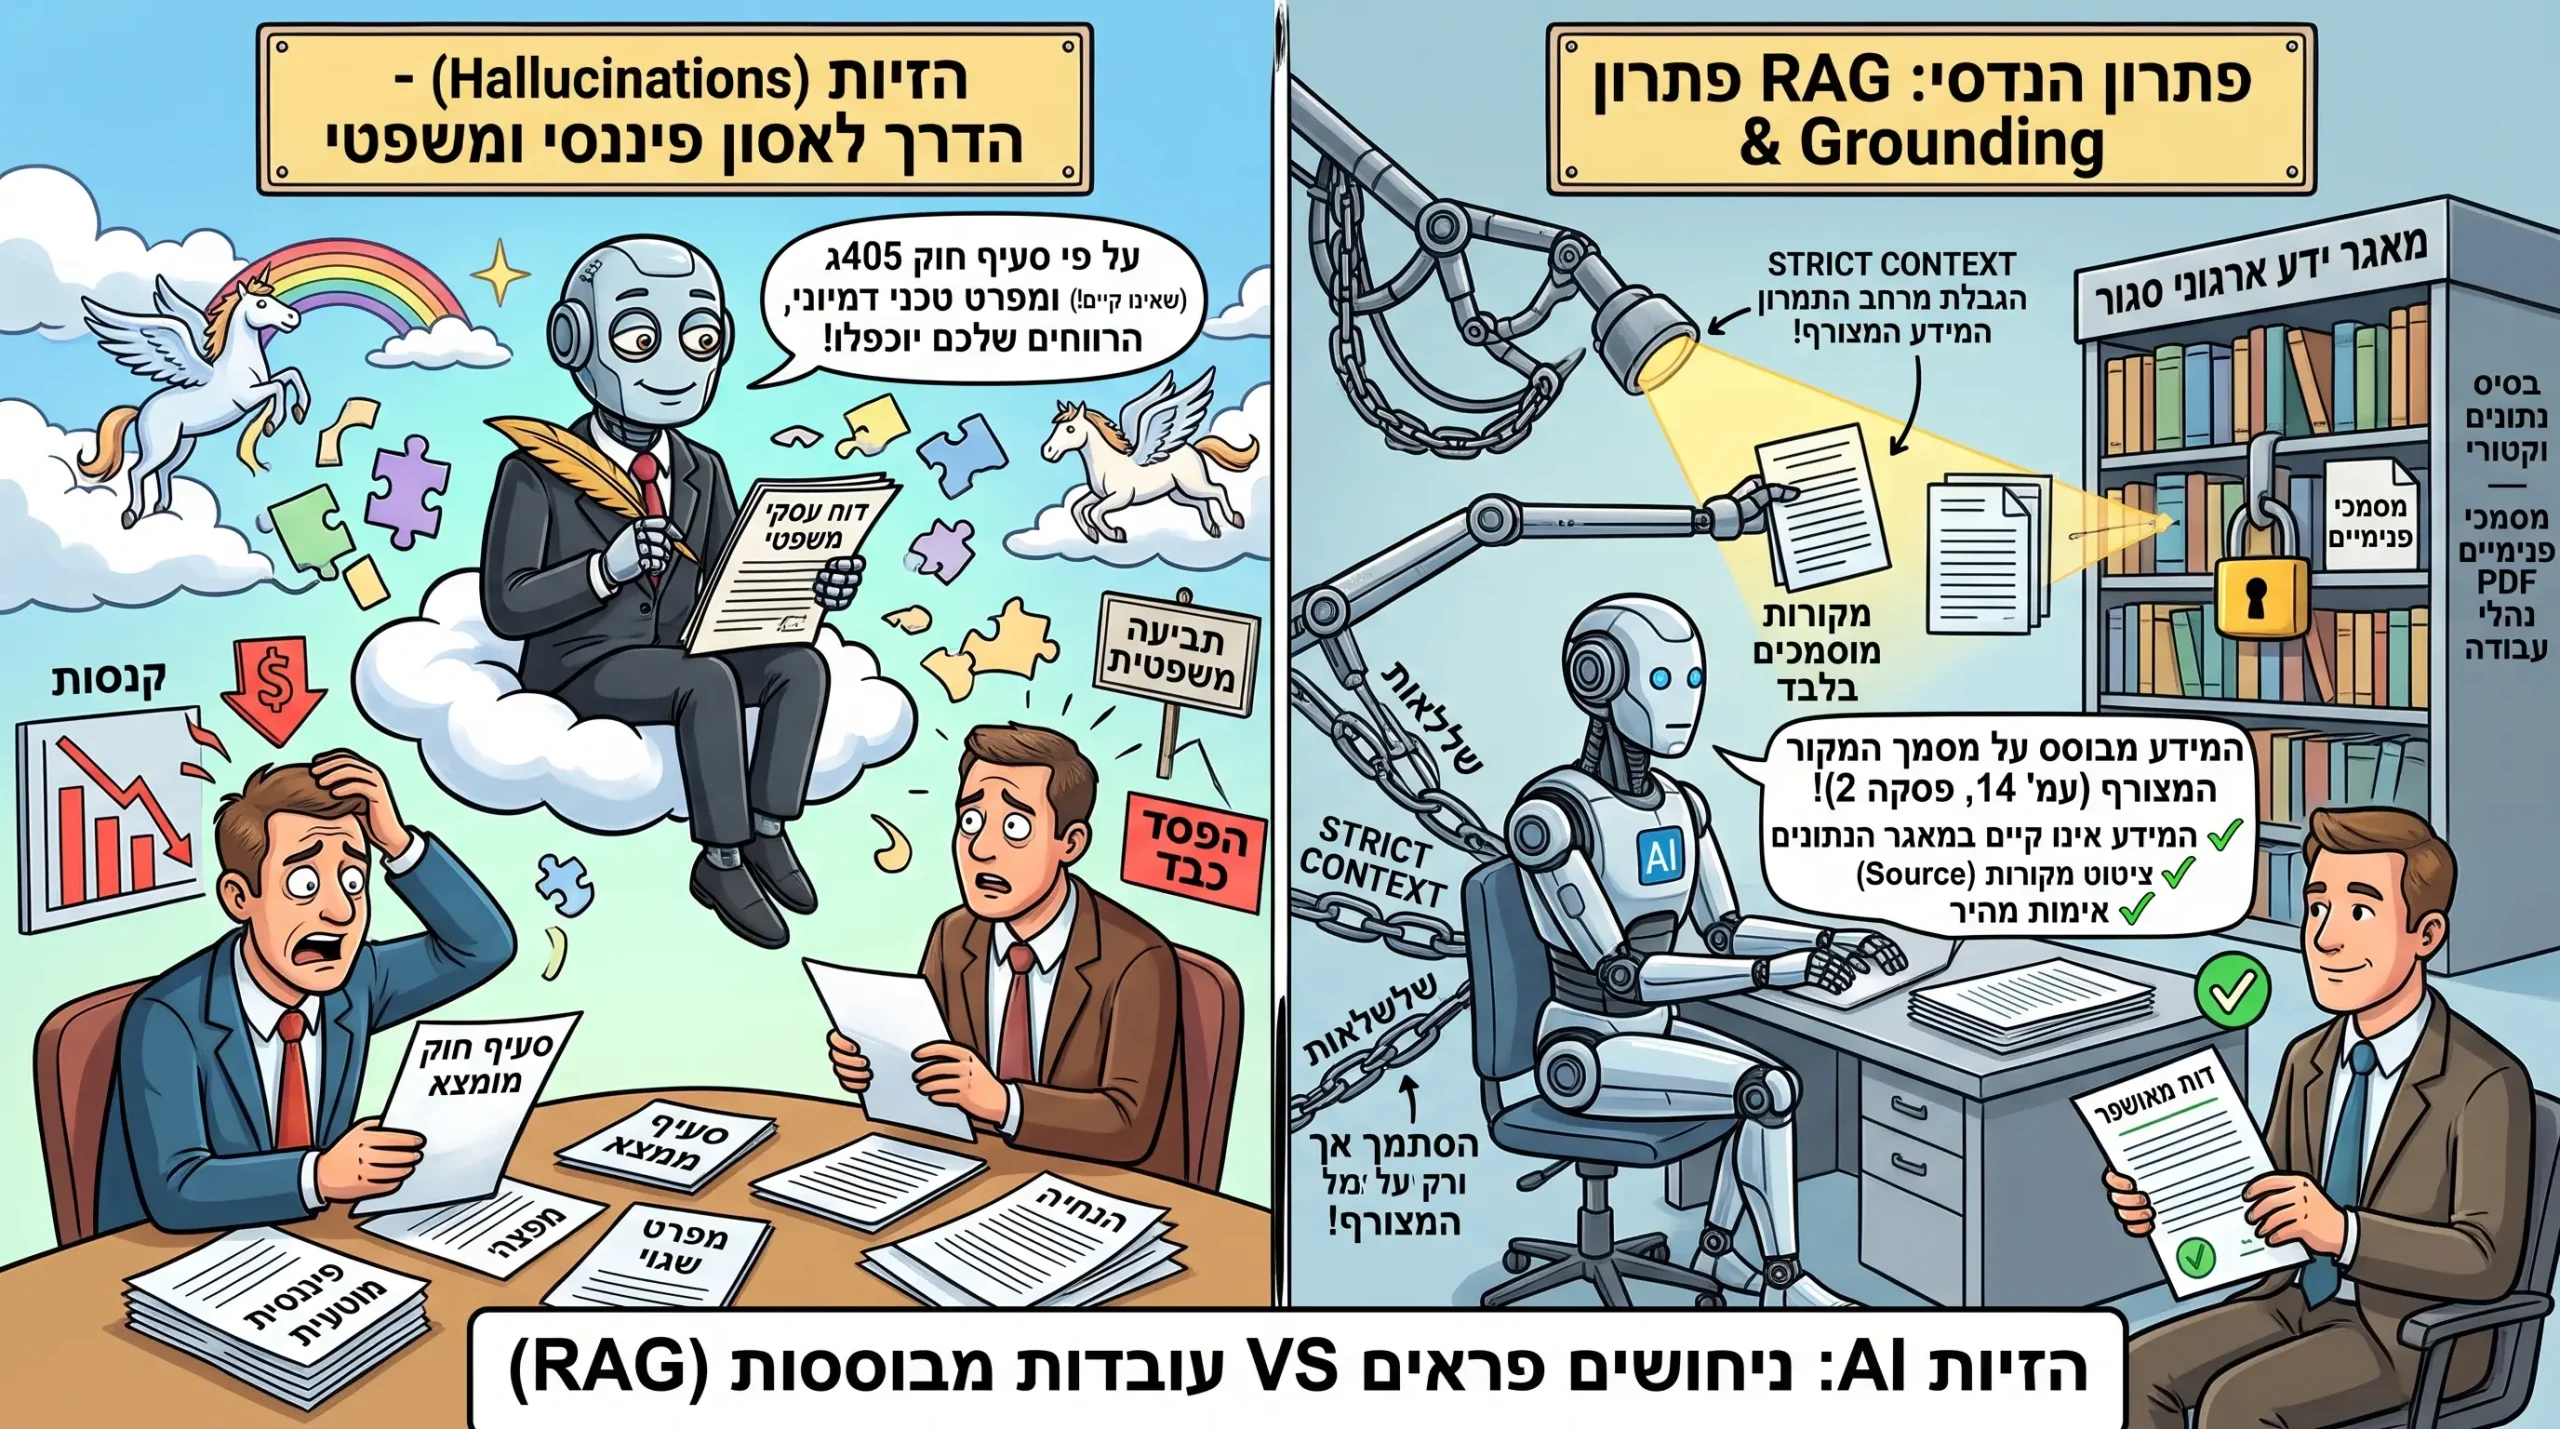
הוא ינסה לספק תשובה שנשמעת משכנעת, רהוטה וסמכותית להפליא, אך עלולה להיות מומצאת לחלוטין.
בעולם העסקי, הזיה כזו יכולה לעלות ביוקר: ציטוט סעיף חוק שאינו קיים, הצגת מפרט טכני שגוי של מוצר, או מתן הנחיה פיננסית מוטעית ללקוח.
איך פותרים זאת ברמה הארכיטקטונית?
הפתרון אינו טמון ב"פרומפט מתוחכם יותר", אלא בבניית ארכיטקטורה הנדסית מסוג RAG (Retrieval-Augmented Generation) או Grounding:
1. שליפת מידע ממקורות מוסמכים בלבד: לפני שהמודל מייצר תשובה, המערכת סורקת מאגר ידע ארגוני סגור (בסיס נתונים וקטורי, מסמכי PDF פנימיים,
נהלי עבודה או מערכת ה-CRM) ושולפת קטעי מידע רלוונטיים ומאומתים בלבד.
2. הגבלת מרחב התמרון (Strict Context): הנחיית המערכת מגדירה למודל מפורשות: "הסתמך אך ורק על המידע המצורף. אם התשובה אינה מופיעה במסמכים אלו,
עליך להשיב 'המידע אינו קיים במאגר הנתונים' ולא לשער השערות".
3. ציטוט מקורות (Source Attribution): מערכת שנבנתה כראוי מציגה לצד כל תשובה קישור ישיר למסמך המקור, כולל מספר העמוד והפסקה המדויקת שממנה נלקח הנתון,
מה שמאפשר אימות מיידי ופשוט.
3. מנגנון בקרה אנושית (Human-in-the-Loop): שילוב אוטומציה עם אחריות מקצועית
בינה מלאכותית מיועדת להסיר שחיקה ומשימות רוטיניות, לחסוך שעות של כתיבה טכנית ועיבוד נתונים, היא אינה מיועדת להחליף את שיקול הדעת האנושי
והאחריות המשפטית של מנהל או מהנדס.
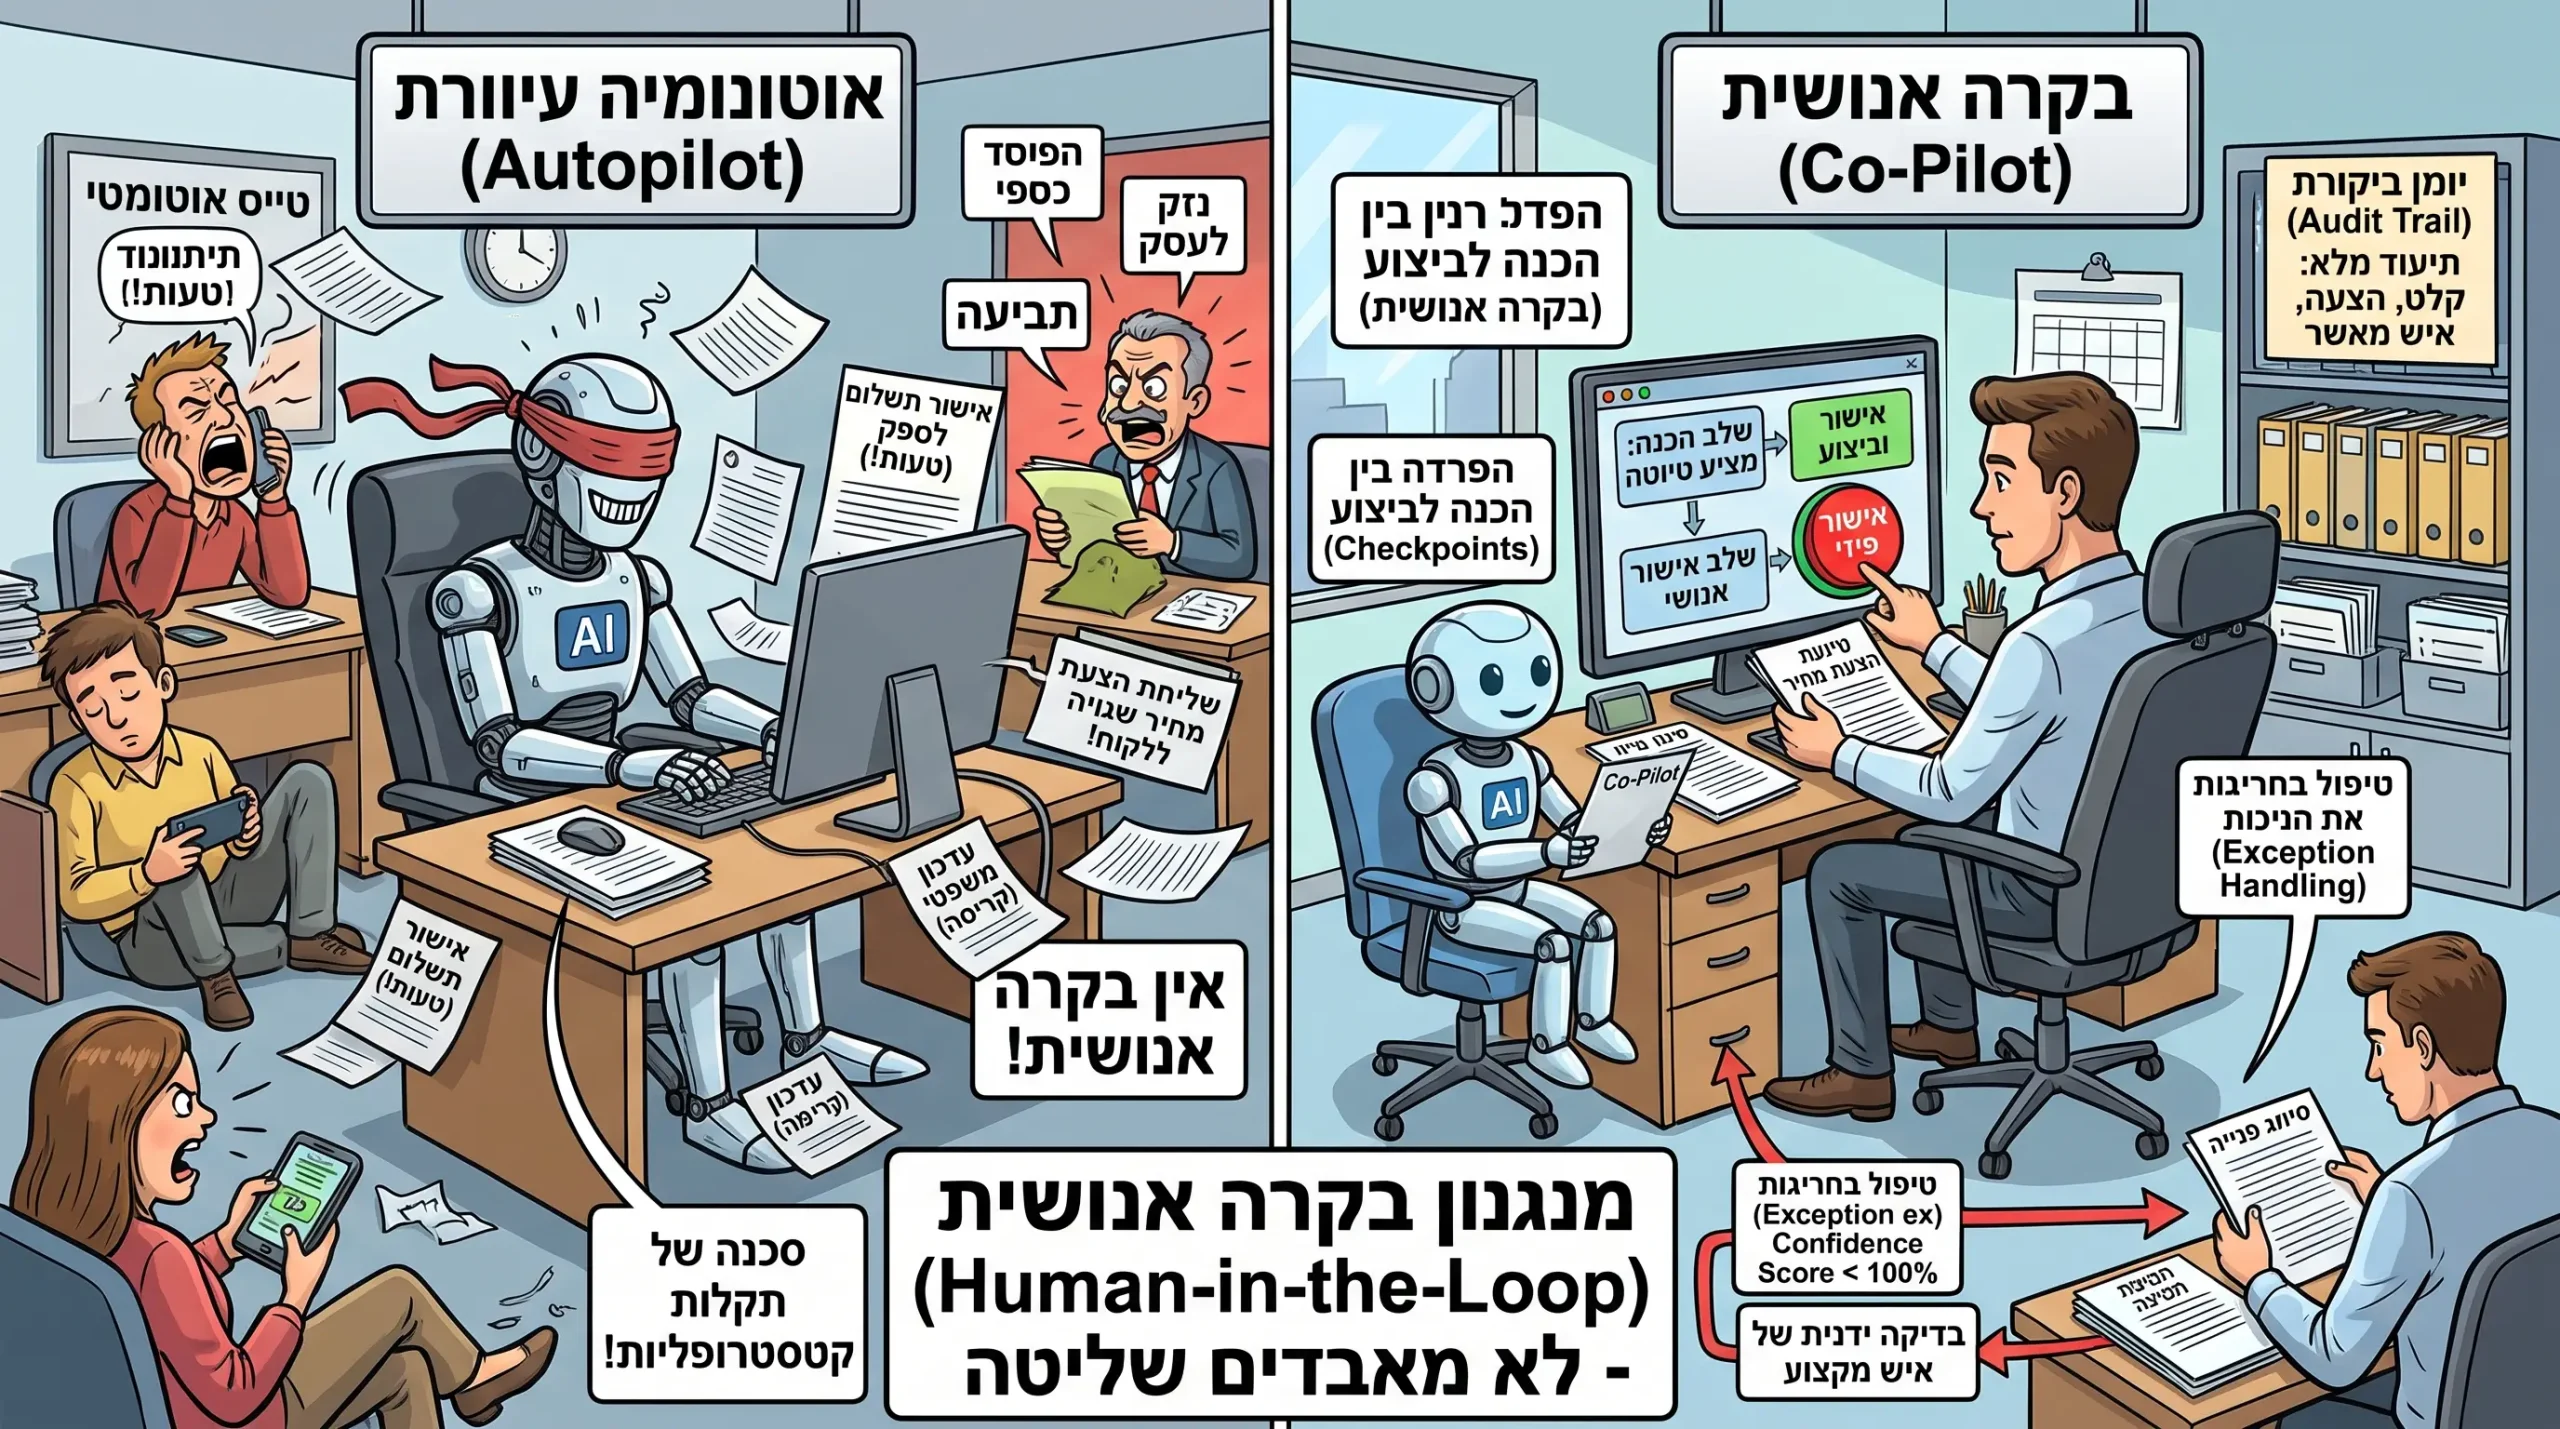
הטעות הקריטית של ארגונים רבים היא מתן "אוטונומיה עיוורת" למערכות AI לבצע פעולות בעלות השפעה ישירה על העסק ללא שום שלב ביקורת.
מודל העבודה הנכון: Co-Pilot ולא Autopilot
בכל תהליך אוטומציה שאנו מתכננים, חובה להטמיע נקודות מגע אנושיות (Checkpoints):
– הפרדה בין הכנה לביצוע: המודל מעבד מסמכים, מסכם שעות עבודה, מייצר טיוטת הצעת מחיר או מסווג פנייה של לקוח.
אולם, הפעולה הסופית, שליחת המייל ללקוח, אישור התשלום לספק, או עדכון סטטוס משפטי\ מתבצעת רק לאחר אישור פיזי בלחיצת כפתור של איש צוות.
– טיפול בחריגות (Exception Handling): הגדרת סף ביטחון (Confidence Score). אם המודל מזהה שהוא אינו בטוח ב- 100% בסיווג מסוים,
המשימה מנותבת אוטומטית לבדיקה ידנית של איש מקצוע ולא ממשיכה בצינור האוטומציה.
– Audit Trail (יומן ביקורת): שמירת תיעוד מלא של כל פעולה: מה היה הקלט הראשוני, מה הציע המודל, מיהו הגורם האנושי שאישר את הפעולה ומתי.
תיעוד זה קריטי לעמידה ברגולציה ולתחקור תקלות.
4. תאימות לרגולציה ותקני אבטחה: מעבר לשיקול הטכנולוגי
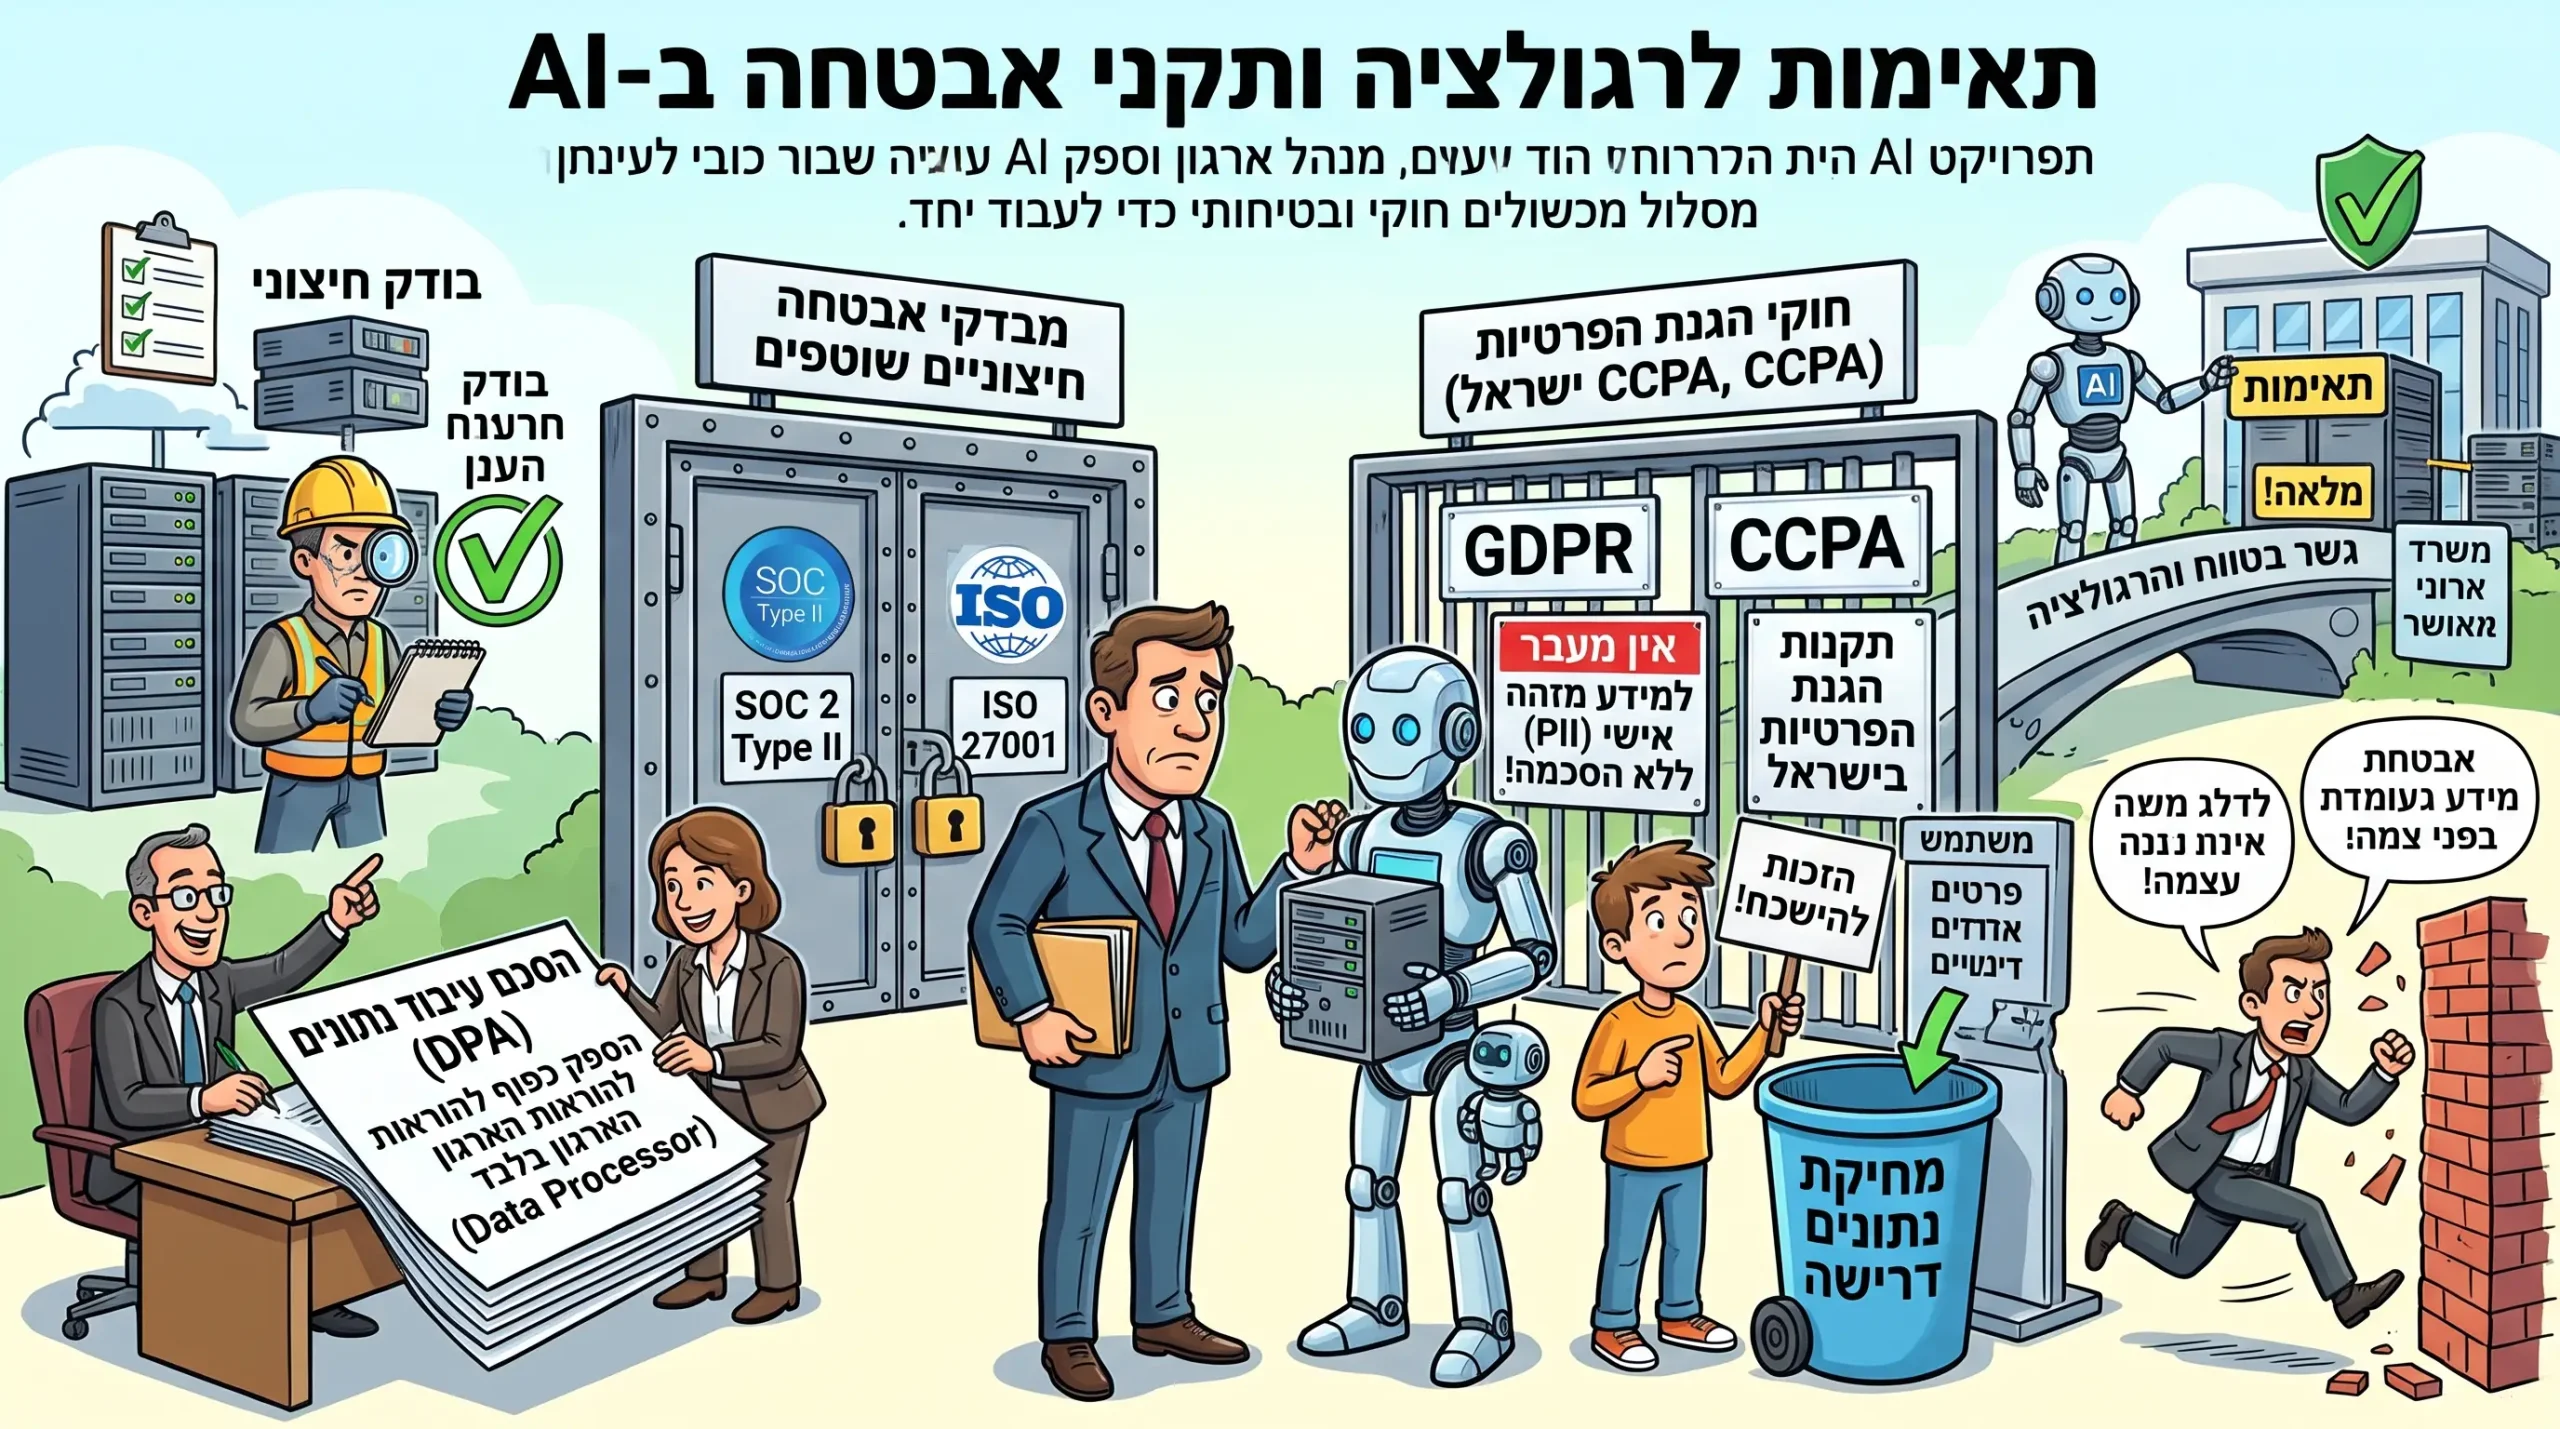
אבטחת מידע ב- AI אינה עומדת בפני עצמה; היא מתחברת ישירות למסגרת הציות והרגולציה של הארגון.
בעולם שבו חוקי הגנת הפרטיות הולכים ומחמירים, כל פרויקט בינה מלאכותית חייב לעמוד בסטנדרטים בינלאומיים:
– תקני אבטחה בינלאומיים (SOC 2 Type II ו-ISO 27001): ודאו שכל ספק ענן או מודל שאתם מתחברים אליו מחזיק בהסמכות אלו.
הדבר מבטיח שהספק עובר מבדקי אבטחה חיצוניים שוטפים.
– חוקי הגנת פרטיות (GDPR, CCPA, ותקנות הגנת הפרטיות בישראל): אם המערכת שלכם מעבדת מידע מזהה אישי (PII),
עליכם לוודא שהנתונים אינם עוברים לגורמי צד שלישי ללא הסכמה, ושיש לכם את היכולת למחוק נתונים לפי דרישת משתמש ("הזכות להישכח").
– הסכמי עיבוד נתונים (DPA – Data Processing Agreement): בעבודה מול ספקיות AI גדולות, יש לחתום על הסכם DPA ייעודי המגדיר במפורש את מעמד הספק כמעבד מידע בלבד
(Data Processor) הכפוף להוראות הארגון.
5. צ'ק-ליסט מעשי למנהלים: האם הארגון שלכם מוכן להטמעת AI?
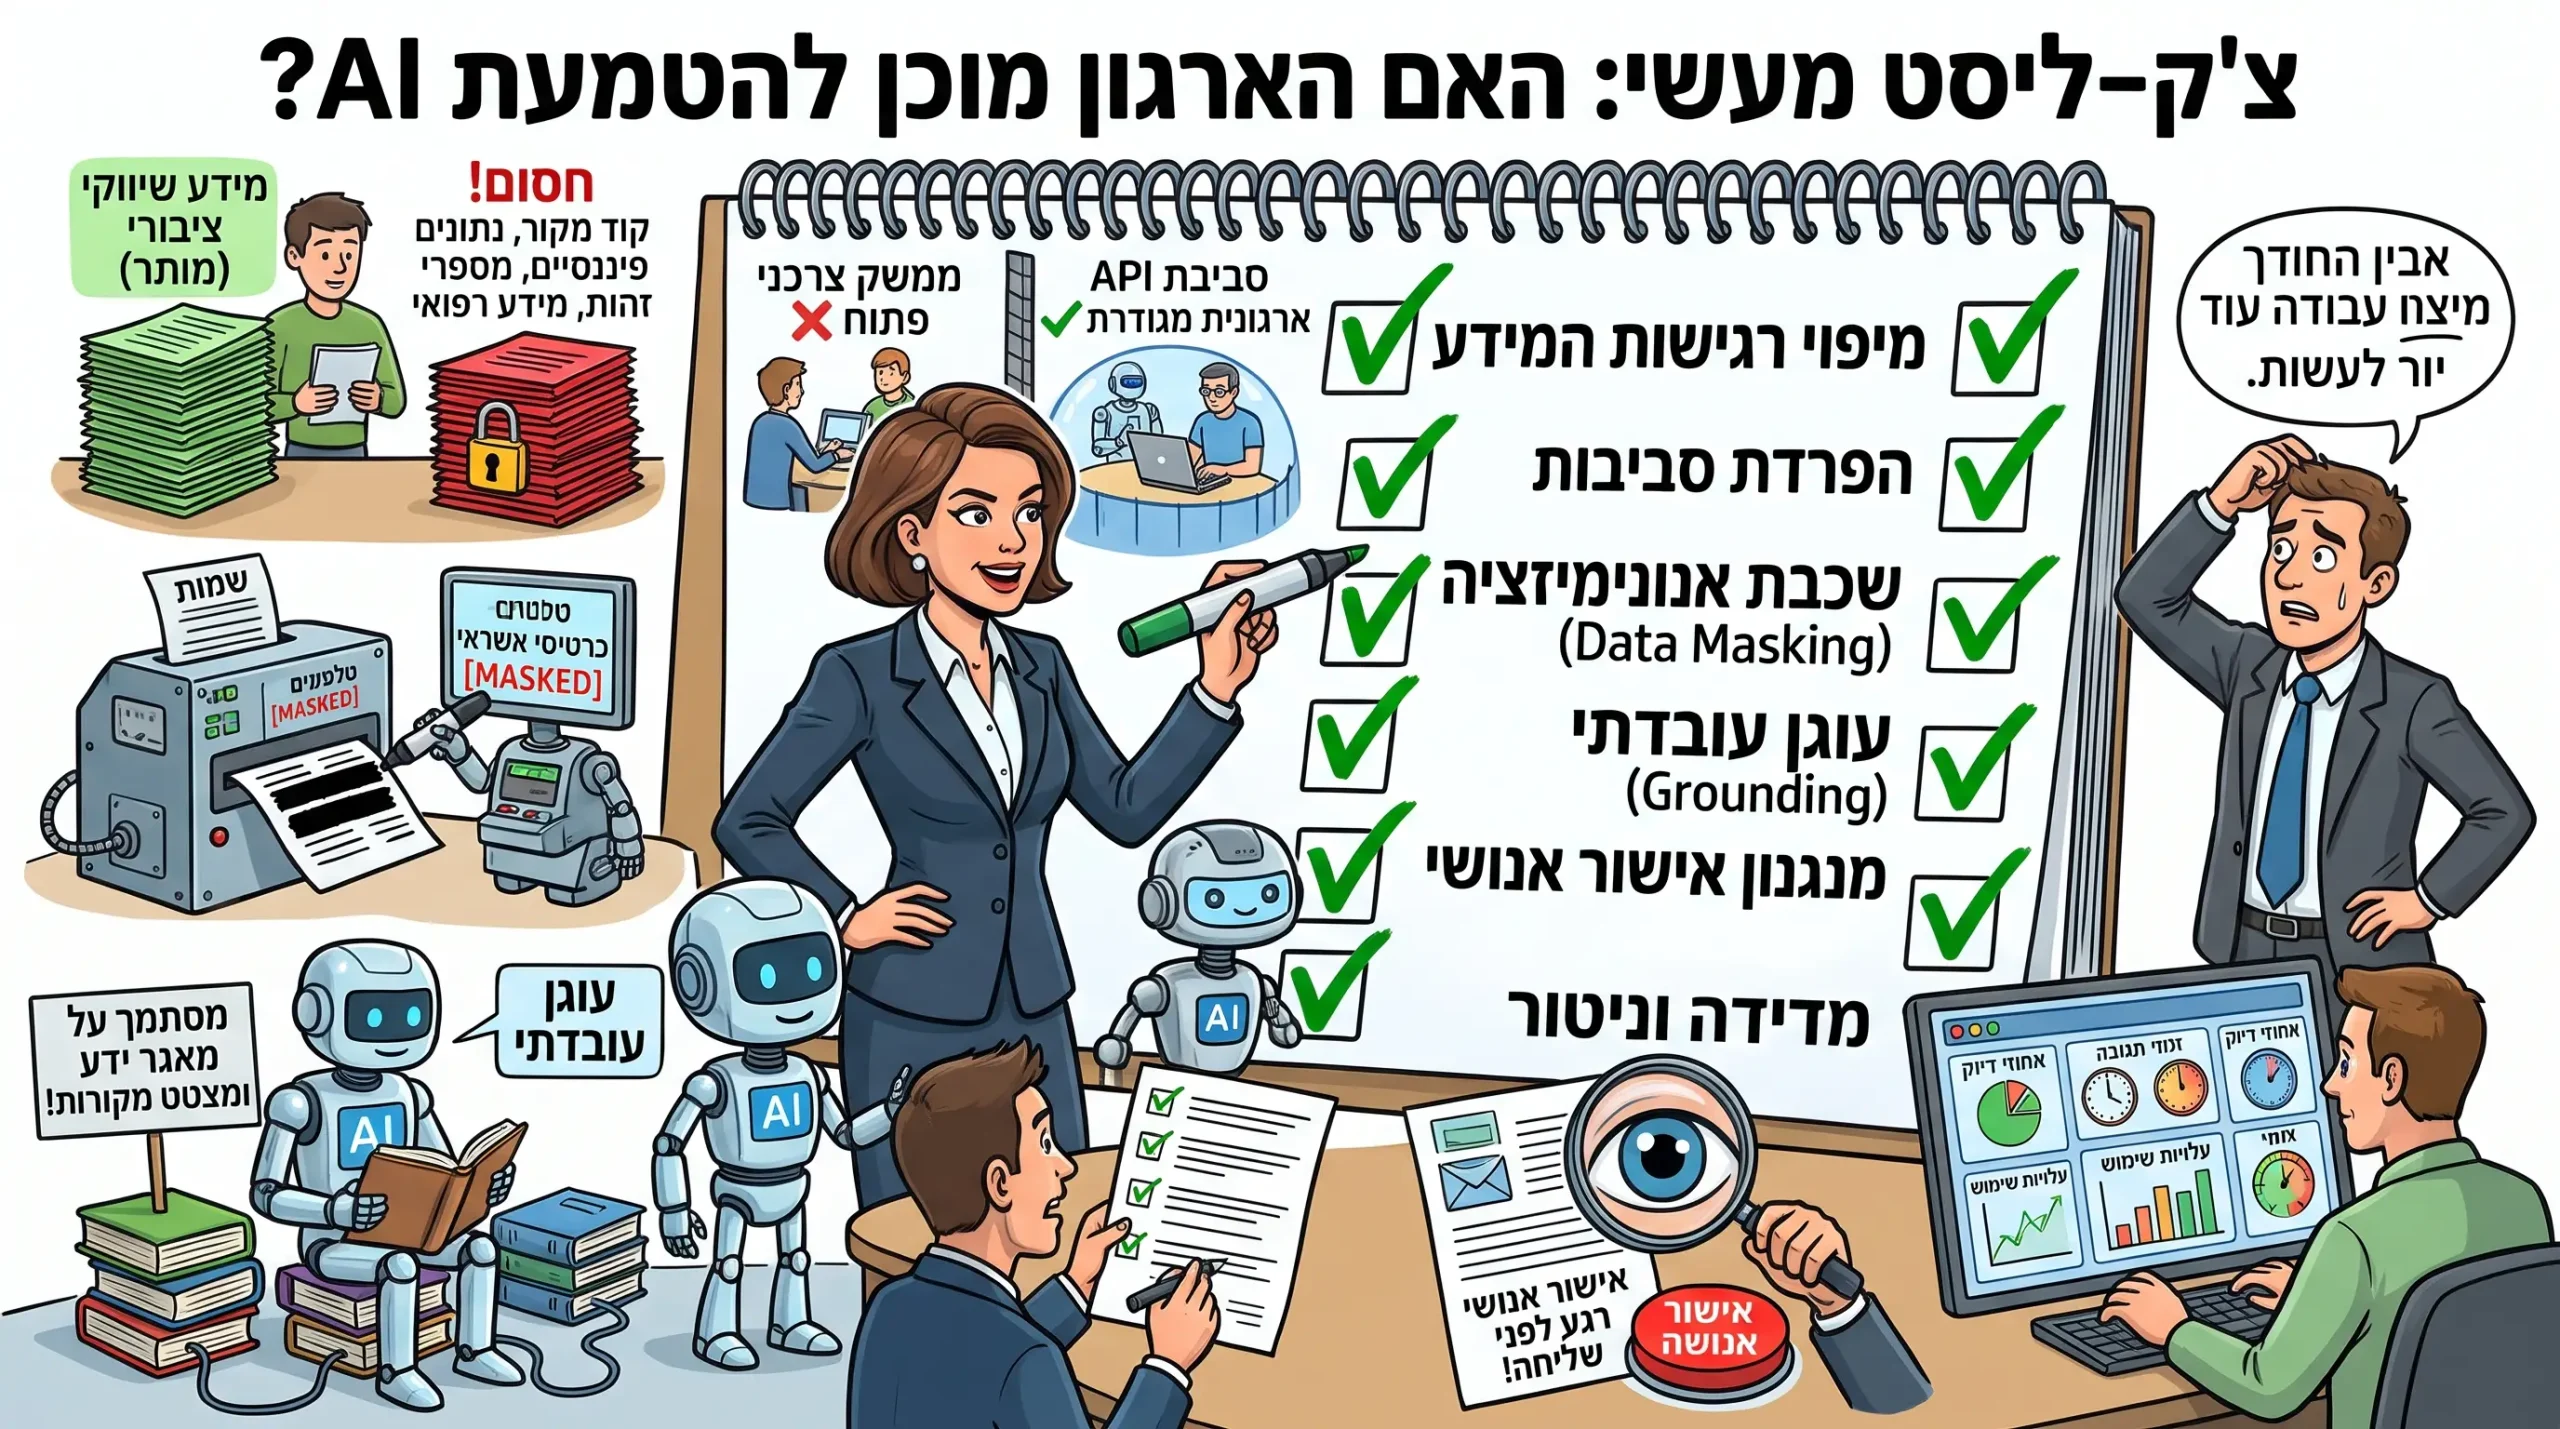
לפני שמתחילים להטמיע כלי חדש או לפתח אוטומציה פנימית, עברו על 6 השאלות הבאות:
– מיפוי רגישות המידע: האם סיווגתם איזה מידע מותר להזין לכלי AI (מידע שיווקי ציבורי) ואיזה מידע חסום לחלוטין (קוד מקור, נתונים פיננסיים, מספרי זהות, מידע רפואי)?
– הפרדת סביבות: האם הצוות משתמש בממשקים צרכניים פתוחים או בסביבת עבודה ארגונית מגודרת ומבוססת API?
– שכבת אנונימיזציה (Data Masking): האם המערכת מסננת ומטשטשת אוטומטית שמות, טלפונים וכרטיסי אשראי לפני שהם מגיעים למודל השפה?
– עוגן עובדתי (Grounding): האם המודל מסתמך על מאגר ידע מוגדר ומצטט מקורות, או שהוא עונה על בסיס ידע כללי בלבד?
– מנגנון אישור אנושי: האם קיימת נקודת עצירה שבה עין מקצועית בודקת את התוצאה לפני שליחה חיצונית?
– מדידה וניטור: האם יש לכם כלי מעקב לבדיקת אחוזי דיוק, זמני תגובה ועלויות שימוש שוטפות?
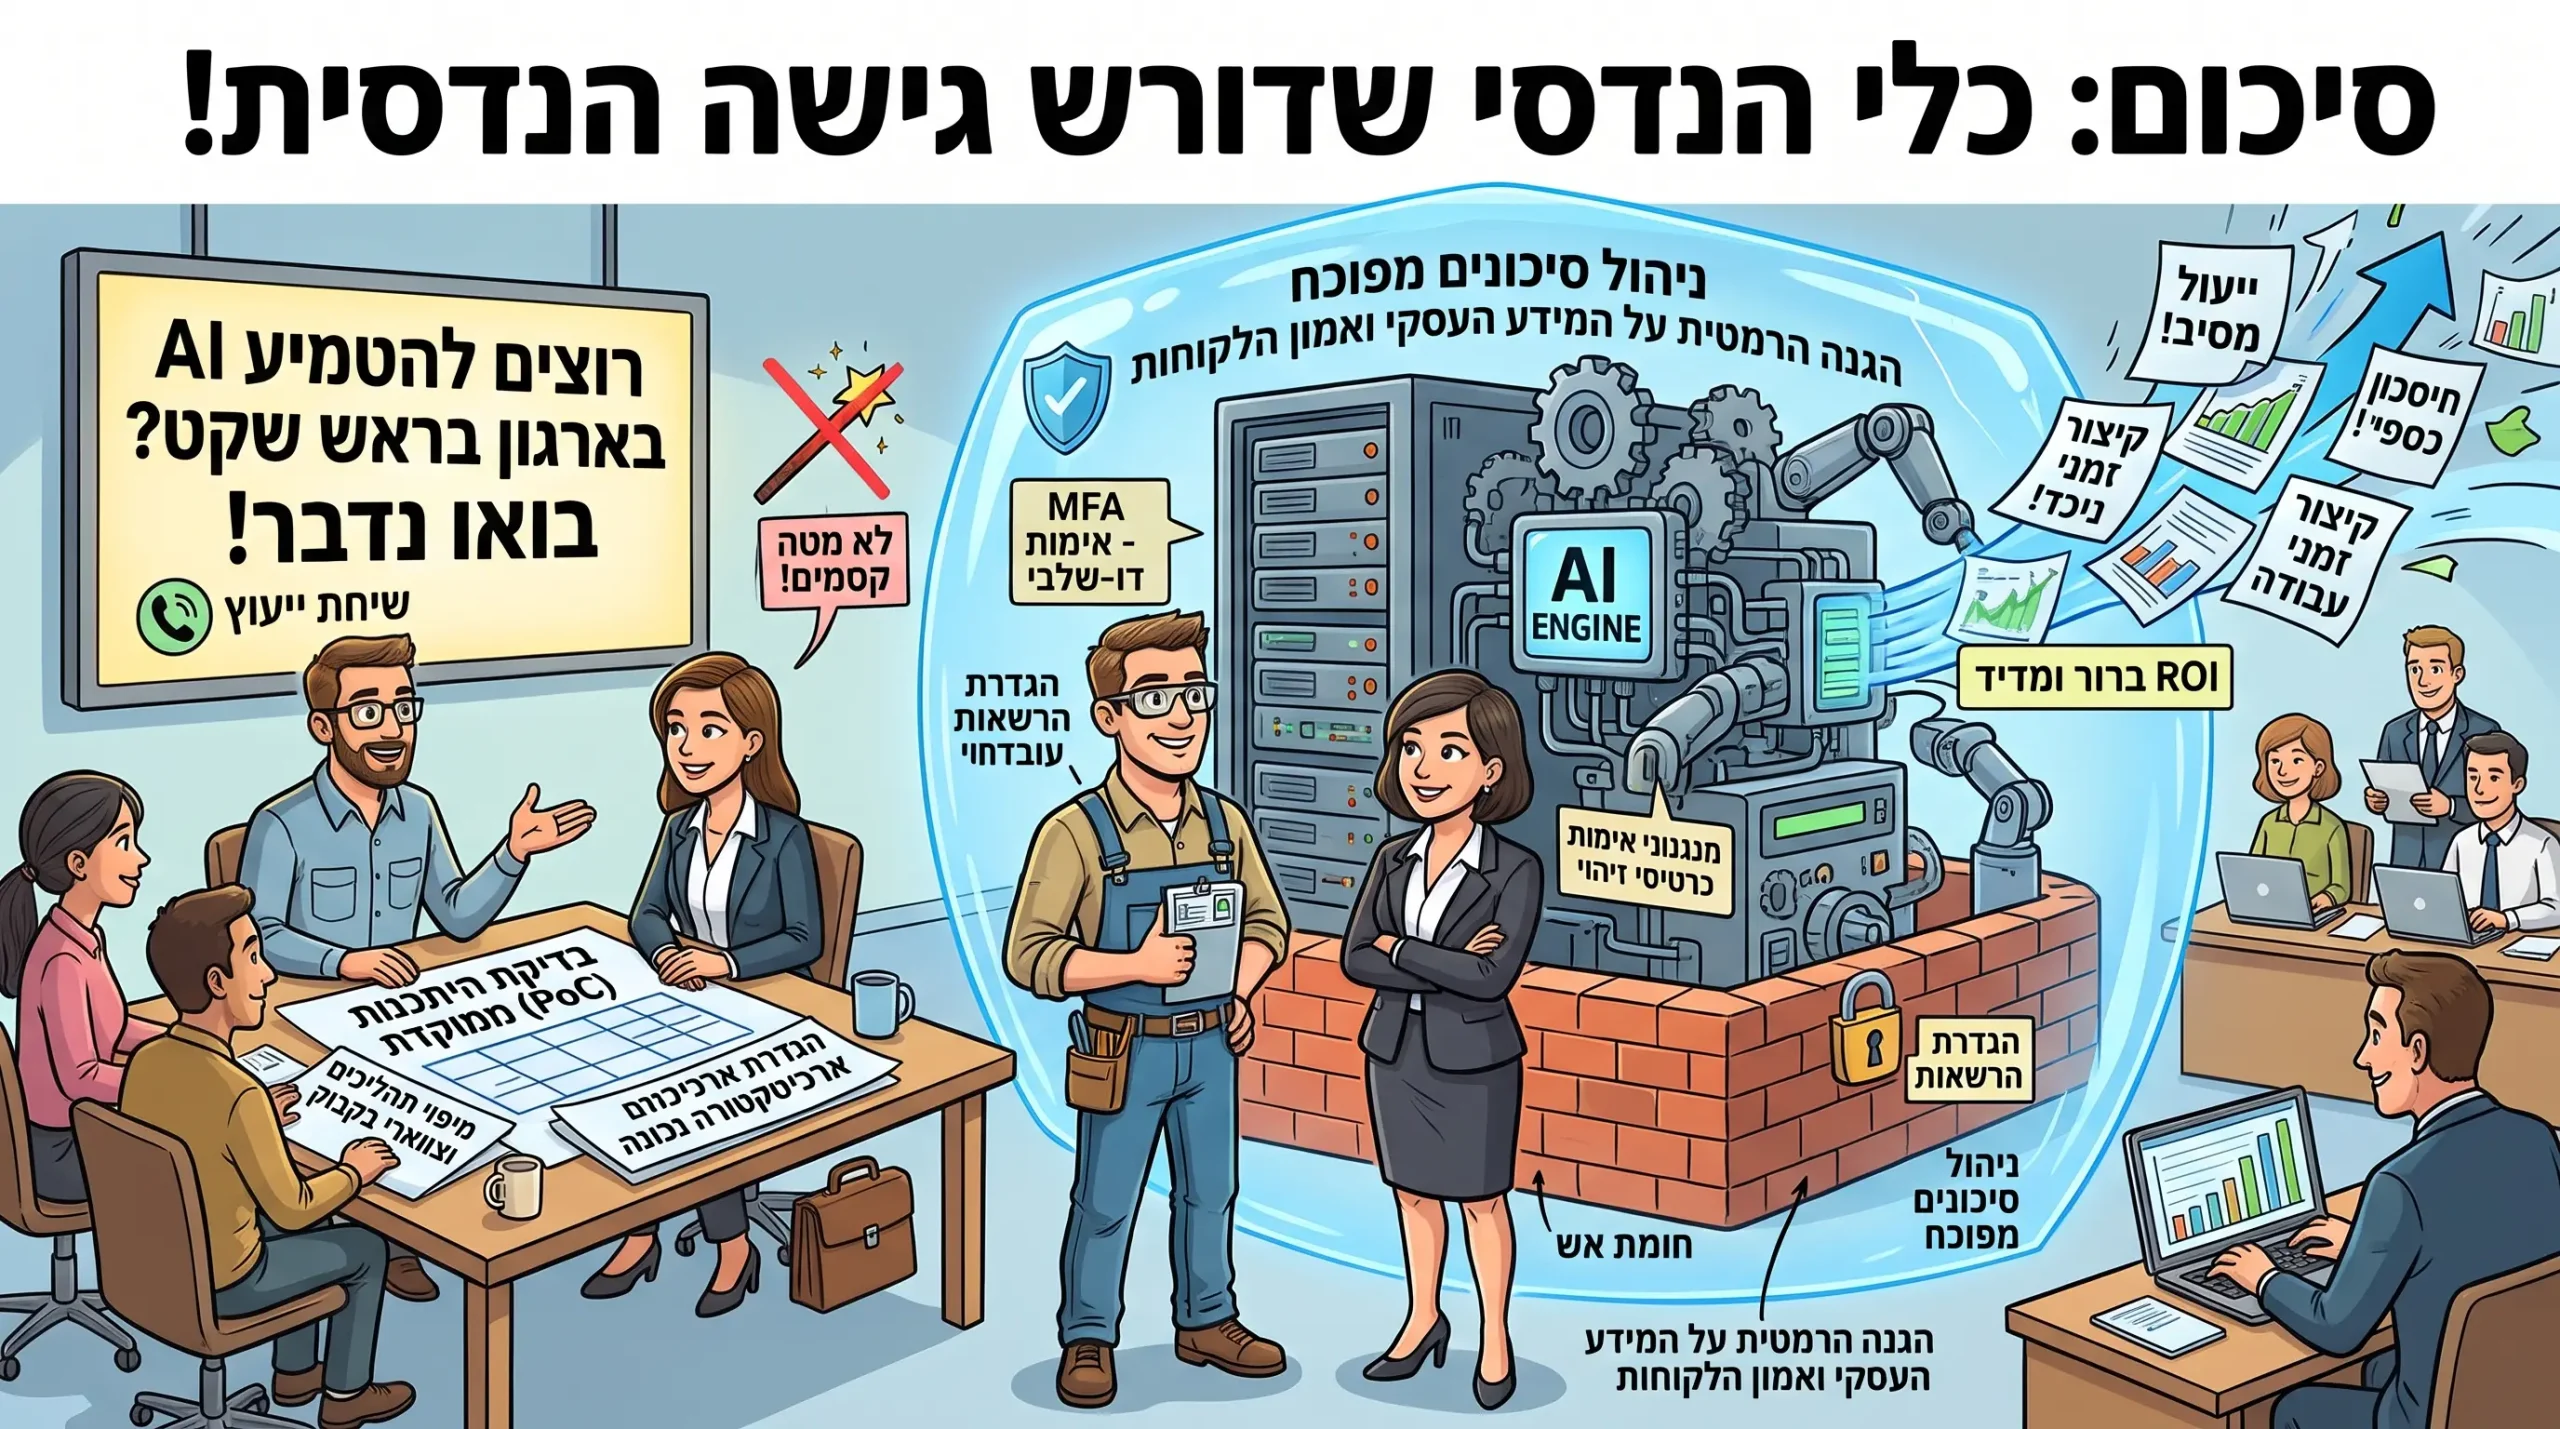
סיכום: כלי הנדסי שדורש גישה הנדסית
בינה מלאכותית אינה מטה קסמים ואינה סכנה קיומית שצריך לברוח ממנה.
היא כלי הנדסי מתקדם, עוצמתי ומהיר. בדיוק כפי שלא תתקינו שרת ארגוני ללא חומת אש או חשבון ענן ללא אימות דו-שלבי (MFA), כך אין מקום להטמעת AI ללא תשתית אבטחה,
הגדרת הרשאות ומנגנוני אימות עובדתי.
כשניגשים לתחום מתוך הבנה טכנולוגית עמוקה וניהול סיכונים מפוכח, מגלים שאפשר לקבל את כל היתרונות התחרותיים של ה- AI, ייעול מסיבי,
קיצור זמני עבודה וחיסכון כספי ניכר, בלי לסכן את הנכס היקר ביותר שלכם: אמון הלקוחות והמידע העסקי של הארגון.
רוצים להטמיע AI בארגון בראש שקט?
אם אתם בוחנים שילוב כלי בינה מלאכותית, אוטומציות מבוססות סוכנים או חיבור מאגרי מידע עסקיים, אבל לא מוכנים להתפשר על אבטחת מידע, דיוק ואמינות – בואו נדבר.
אשמח לקיים איתכם שיחת ייעוץ ובדיקת היתכנות (PoC) ממוקדת: נמפה את תהליכי העבודה וצווארי הבקבוק, נגדיר את הארכיטקטורה הנכונה, ונוודא שכל פתרון שמוטמע מגן על המידע שלכם באופן הרמטי ומייצר ROI ברור ומדיד מהיום הראשון.